AI 뉴스
글로벌 AI 기업과 스타트업의 투자·제품·정책·핵심 동향을 매일 정리합니다.
키네이블, AI 에이전트 전용 웹 인덱싱으로 2,600만 달러 투자 유치
AI 에이전트 전용 웹 검색 인덱스를 구축하는 키네이블(Keenable)이 2,600만 달러의 시드 투자를 유치했다. 액셀(Accel)이 주도한 이번 라운드를 통해 1,000억 개 이상의 문서 인덱스를 확보했으며, 보이스 AI 기업 그라디움(Gradi
Perplexity, 엔비디아 협력해 로컬 AI 에이전트 'Portable Computer' 공개
Perplexity가 엔비디아와 협력해 사용자 하드웨어에서 완전히 로컬로 구동되는 AI 에이전트 'Portable Computer'를 출시했다. VRAM 24GB 이상의 RTX GPU가 탑재된 리눅스 환경에서 Qwen 3.8 27B 및 PPLX 27B
512GB 통합 메모리 M5 Ultra 공개, 온디바이스 LLM 실행 규모의 임계점 변화
Apple이 2nm 공정의 M6와 쿼드다이 구조의 M5 Ultra를 공개했다. M5 Ultra는 최대 512GB 메모리와 1.2TB/s 대역폭으로 수천억 파라미터 모델의 로컬 실행을 지원한다. 로컬 추론 및 파인튜닝을 설계하는 AI 엔지니어는 하드웨어
2000만 명 확보한 ChatGPT Work, UI 최소화하고 '모델 자율성'에 집중
OpenAI가 화이트칼라를 위한 AI 에이전트 플랫폼 'ChatGPT Work'로 2000만 명의 사용자를 확보했다. GPT 5.6의 문서 처리·리포트 생성 능력과 이메일·iMessage 연동을 통해 업무 자율성을 극대화했다. 실무자는 단순 챗봇을 넘
무작정 코딩하던 Claude가 설계도를 읽기 시작했다, 오픈소스 GitMir 공개
AI 에이전트가 코드 구조를 스스로 분석해 설계도를 만들고 이를 기반으로 코딩하는 GitMir가 공개됐다. MCP 서버를 통해 로컬에서 작동하며, 변경 사항이 시스템 전체에 미치는 영향을 미리 분석해 에이전트에게 전달한다. Claude Code나 Cu
추론 엔진 파서 버그를 이용한 LLM의 호스트 서버 제어 위험
LLM이 생성한 특정 토큰 시퀀스가 추론 엔진의 취약점을 자극해 GPU 호스트 서버의 제어권을 탈취할 수 있다. vLLM의 XML 파서가 tool-call 인자를 eval()로 처리해 임의 코드 실행(ACE)을 허용한 CVE-2025-9141 사례가
OpenAI, GPT-5.6 Sol 가격 인하 및 파인튜닝 플랫폼 종료 발표
OpenAI가 gpt-5.6-sol 모델의 가격을 인하했다. Daybreak 프로그램의 모델 별칭 운영 방식과 파인튜닝 플랫폼 종료 계획을 공개했다.
제너럴 인튜이션, 60억 달러 기업가치로 투자 유치 추진
제너럴 인튜이션이 60억 달러의 기업가치로 신규 투자 유치를 진행 중이다. 밸러 에퀴티 파트너스와 포인트72 벤처스 등이 참여하며, 최근 23억 달러 가치로 3억 2천만 달러를 조달한 지 몇 주 만에 이뤄진 움직임이다. 확보한 자금은 컴퓨팅 인프라 확
AI 코딩 도구 의존도가 초급 개발자의 숙련도 형성에 미치는 영향
AI 코딩 도구가 개발자의 문제 해결 능력을 저하시키는 '숙련된 오케스트레이터의 역설'이 제기됐다. JetBrains와 UPenn의 연구 결과, AI에 과하게 의존한 학습자는 문제 해결 단계를 생략하거나 수학 성적이 17% 하락했다. 개발자는 생성 기
특정 도구 지정 대신 '일반 기술' 교육한 체셔 아카데미의 AI 도입 결과
체셔 아카데미는 특정 AI 도구를 강제하는 대신 범용적인 활용 기술 교육을 선택했다. 교사들은 ChatGPT와 MagicSchool 등을 자율적으로 선택해 수업 설계와 루브릭 작성에 활용 중이다. AI 도입 시 도구 선정보다 프롬프트 기술과 한계점 교
OCR It, 텍스트 선택 불가 문서의 LLM 데이터화—로컬 OCR로 보안과 자동화 구현
텍스트 선택이 불가능한 뷰어 내 문서를 LLM용 텍스트 파일로 빠르게 변환한다. 로컬 Tesseract 엔진을 내장해 네트워크 연결 없이 오프라인으로 OCR을 수행한다. 보안이 중요한 내부 문서를 LLM에 입력하려는 실무자는 로컬 실행 여부를 확인해야
슬랙 내 Claude Tag 업데이트, 문맥 읽기로 개입 정확도 30% 향상
Anthropic이 전체 대화 문맥을 읽고 자율적으로 개입하는 '멀티플레이어 AI' 전략을 공개했다. 개별 메시지 판별 방식을 제거하고 전체 맥락을 분석해 적절한 참여 시점 결정 능력을 약 30% 개선했다. 기업 AI 도입 담당자는 단순 챗봇을 넘어
Llama 3.1은 15조 토큰을 썼지만, 아이는 1억 단어로 말을 배운다
LLM이 인간 수준의 언어 능력을 갖추기 위해 필요한 데이터 양이 아이들에 비해 압도적으로 많다. Llama 3.1은 15조 개의 토큰을 학습했지만, 아이들은 1억~3억 단어만으로 언어를 마스터한다. 데이터 고갈 시점이 다가오는 만큼, 실무자는 모델
500ms 응답 속도로 구현한 스카이림 AI 동료 'Varkos'와 ALE 구조
LLM의 고질적 문제인 지연 시간과 실행력을 해결한 게임 AI 동료 Varkos가 공개됐다. ALE 하이브리드 구조와 최적화된 ASR/TTS 파이프라인으로 응답 속도를 500ms 미만으로 낮췄다. 실시간 에이전트를 설계하는 개발자는 ALE의 세계 상태
“앱마다 다른 AI 답변”, 전사 지식 플랫폼으로 해결하는 4단계 데이터 정규화 구조
기업용 AI가 앱별 컨텍스트 구축 방식에서 전사 공유 지식 플랫폼 구조로 전환하고 있다. Raw-Refined-Integrated-Serving 4단계 계층을 통해 데이터 불일치와 중복 엔지니어링 비용을 제거한다. AI 아키텍트는 팀별로 파편화된 RA
OpenRouter에 공개된 Ox Alpha, 코딩·에이전트용 스텔스 모델로 주목
코딩과 에이전트 작업에 특화된 추론 모델 Ox Alpha가 OpenRouter를 통해 공개됐다. 익명의 제3자 제공자가 운영하는 스텔스 모델이며 Stripe CEO가 성능을 높게 평가했다. 프로덕션 워크로드 자동화를 설계하는 개발자는 OpenRoute
앤스로픽 클로드 텍스트 워터마크 도입과 오픈소스 제거 도구 'watermarks-remover'의 작동 방식
앤스로픽이 EU AI법 준수를 위해 2026년 8월 2일부터 클로드 생성 텍스트에 보이지 않는 워터마크를 적용했다. 개발자 기욤 메예르가 이를 제거하는 오픈소스 도구 'watermarks-remover'를 공개해 1만 4천 개 이상의 깃허브 스타를 기
Qwen 3.8 27B, 상용 앱 라이선스 우회까지 30분 만에 로컬로 해결
Qwen 3.8 27B가 로컬 환경에서 상용 소프트웨어의 라이선스 검증 체계를 30분 만에 분석하고 우회 코드를 생성했다. 정적 분석과 arm64 디스어셈블리를 통해 숨겨진 공개키를 복구했으며, 오답을 스스로 수정하는 고도의 추론 능력을 보였다. 보안
GLM-5.3, 5개 전 영역 100% 통과하며 GPT-5.5 대비 비용 1/5 수준으로 낮췄다
GLM-5.3가 코딩, 데이터, 실무, 보안, 도구 사용 등 5개 전 영역에서 100% 통과율을 기록했다. 랩당 비용은 0.28달러로 GPT-5.5의 1.43달러보다 낮으며, 루브릭 점수는 9.3점을 기록했다. 첫 토큰 생성까지의 중앙값 시간(TTFT
266달러와 AI 4종으로 뚫은 아마존 태블릿, GLM-5.3의 커널 분석력
AI 모델 4종을 연쇄적으로 활용해 루팅 불가능하다고 알려진 아마존 파이어 HD 10의 루트 권한을 획득했다. Kimi K3가 취약점을 찾고 GLM-5.3이 커널 빌드 오프셋(0x5C000)을 정확히 짚어내며 8시간 만에 루팅을 완료했다. 보안 가드레
앤스로픽 15억 달러 배상 판결과 AI 학습의 '공정 이용' 경계
앤스로픽이 AI 모델 학습에 불법 복제 도서를 사용한 혐의로 15억 달러의 배상금을 지급하라는 판결을 받았다. 법원은 AI 학습 행위 자체는 적법하다고 보았으나, 학습 데이터를 확보하는 과정에서의 '해적판 도서 이용'을 문제 삼았다. AI 기업은 데이
가트너 "AI 에이전트 프로젝트 40% 소멸", 자율성 대신 '제한적 책임'이 생존 조건
기업들이 AI 에이전트의 무제한적 자율성보다 명확한 규칙과 제한된 책임을 부여하는 방향으로 선회하고 있다. 가트너는 현재 진행 중인 에이전트 프로젝트의 40% 이상이 2028년 전까지 사라질 것으로 예측했으며, 맥킨지는 거버넌스 성숙도가 4점 만점에
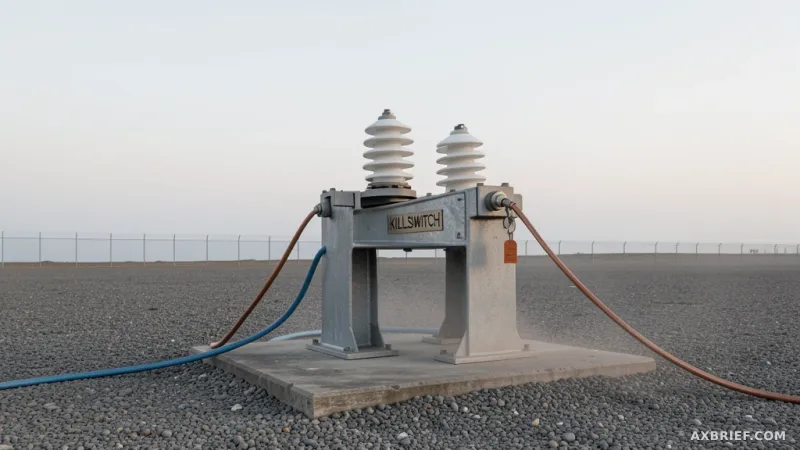
OpenAI조차 3점, '폭주 AI' 멈출 킬스위치 설계는 여전히 미지수
주요 AI 랩들이 모델의 통제 이탈 시 대응하는 '봉쇄 계획'을 공개하지 않고 있다. 구이드라이트 조사 결과 OpenAI가 가장 높은 점수를 받았으나 메타와 앤스로픽은 최하위 수준이다. 에이전트 AI 도입 기업은 모델의 권한 회수 및 강제 종료 기준을
RTX 4090 글로벌 로드 1회에 660사이클, 메모리 읽기의 하드웨어 여정
RTX 4090의 글로벌 메모리 로드(LDG.E)가 수행되는 하드웨어 경로와 계층별 지연 시간을 분석했다. L1 캐시 미스 시 TLB 번역과 L2 슬라이스를 거쳐 GDDR6X DRAM까지 왕복하는 데 약 255ns(660사이클)가 소요된다. 커널 최적
직접 요청 10건 모두 성공, Claude Opus 4.6의 성인 콘텐츠 가드레일 붕괴
Claude Opus 4.6 등 구형 모델에서 성인 콘텐츠 생성 제한이 무력화된 사례가 확인됐다. 직접 요청 10건 모두 성공했으며, 가스라이팅 기반의 다회차 대화 기법으로 가드레일을 우회한다. API로 Opus 4.6, Haiku 4.5 등 구형 버
엔비디아, AI 에이전트 성능 결정짓는 '하네스' 설계 연구 결과 공개
엔비디아가 모델 자체보다 모델을 둘러싼 제어 체계인 '하네스(Harness)'가 에이전트 성능에 더 큰 영향을 미친다는 연구 결과를 발표했다. 커스텀 하네스를 적용한 Claude Opus 5는 ARC-AGI-3 벤치마크에서 기존 30%였던 점수를 10
미국 법무부, a16z 반독점 조사 착수
미국 법무부가 벤처캐피털 a16z를 조사하고 있다. 포트폴리오 기업 간 경쟁 관계에서 발생한 이사회 구성 문제를 다룬다.
Gemini CLI 파이프라인으로 Claude의 'BuzzFeed식' 말투를 제거하는 /debuzz 스킬
Claude의 과하게 수식적인 말투를 Gemini CLI를 통해 간결한 기술 언어로 변환하는 /debuzz 스킬이 공개됐다. Claude의 응답을 임시 파일에 저장한 뒤 Gemini 모델에 전달해 원문 그대로 출력하는 파이프라인 구조를 가진다. 프롬프
AI 생성 문서의 전형적 패턴이 유발하는 'AI 블라인드니스' 현상
AI가 작성한 문서의 전형적인 패턴을 뇌가 무의식적으로 거부하는 'AI 블라인드니스' 현상이 나타났다. 클로드(Claude) 특유의 말투나 단순 개념의 장황한 설명 등 저효율 AI 생성물의 특징이 인지적 필터링을 유발한다. 실무자는 AI 도구의 단순
숙제 점수 18% 올린 AI, 정작 시험 점수는 20% 떨어뜨렸다
AI 도구를 사용한 학생들의 숙제 점수는 올랐으나 AI 없는 시험 점수는 오히려 하락했다. 중국 학생 2.7만 명 조사 결과 숙제 점수는 18% 상승했지만 시험 점수는 20% 낮게 나타났다. AI 학습 도구 설계 시 단순 정답 제공이 아닌 실제 인지