인프라 성능 최적화부터 오픈웨이트 모델의 경제학 변화까지, AI 업계의 주요 소식을 폭넓게 짚어본다. 코어위브(CoreWeave)는 서비스 수준 협약(SLA)을 유지하고 지연 시간 증가를 막기 위해 할당 처리량(provisioned throughput)과 KV 캐시 인식 라우팅을 도입하고 있다. 루빈 시스템즈(Reuben Systems)와 코어위브 인프라는 추론 성능을 높이기 위해 NVFP4 양자화와 예측형 분할(predictive disaggregation)을 채택하는 중이다. 한편 오픈웨이트 모델은 개발자가 전체 지연 시간(end-to-end latency)과 프리픽스 캐싱(prefix caching)을 우선시할 때 복잡한 작업 흐름(workflow)을 소화할 수 있는 품질 수준에 도달했다. 이 밖에도 모델 조율을 위한 자동화된 연구 루프, 추론 기반 비디오 편집 통합, 자율 행동 지원 구성, 모델 소유권을 둘러싼 생태계 제약, 그리고 오픈AI 내부 저장소 유출과 프런티어 모델의 고도화된 해킹 시연 등 최근 보안 사고가 함께 다뤄진다.
01리버사이드 편집에 도입된 클로드 AI의 대화형 편집 방식
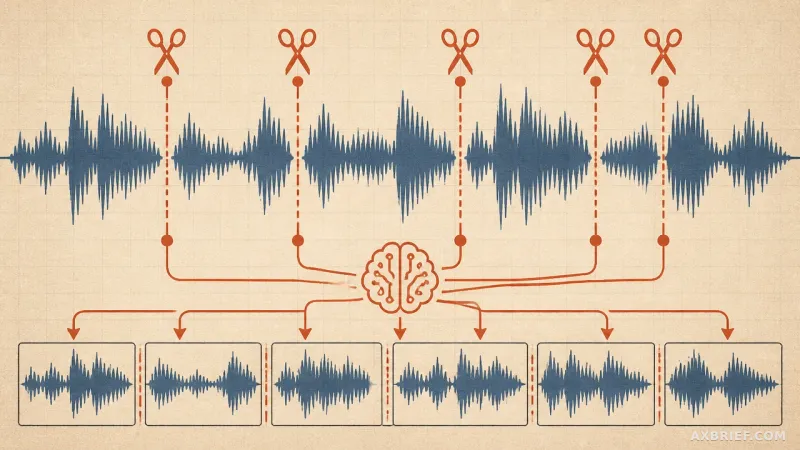
비디오 편집은 단순한 수작업을 넘어 협업 대화 형태로 진화한다. 리버사이드(Riverside)에 클로드를 결합하면서 편집 과정은 단순히 자동 결과물을 맹신하는 방식에서 추론 기반 대화 방식으로 바뀐다. 사용자는 완성된 파일을 받고 AI가 알아서 편집했기를 바라는 대신, AI가 녹화본에서 무엇을 지웠는지, 그리고 그 선택의 근거가 무엇인지 정확하게 물어볼 수 있다. 이를 통해 편집자는 AI의 결정을 반박하거나 검증하며 협상하듯 작업을 진행할 수 있고, 결과물에 화자의 의도와 대화 흐름이 온전히 남게 된다.
또한 이번 통합은 편집의 첫 단계에서 파일을 찾고 화자가 말을 더듬은 지점을 일일이 수동으로 찾느라 낭비하던 지루한 탐색 과정을 없애준다. AI가 녹화본의 정리가 필요한 부분을 자동으로 찾아내고 식별함으로써, 프로젝트를 시작할 때 부딪히는 가장 반복적인 장애물이 사라진다.
이 시스템은 편집 도구에서 만든 클립을 퍼블릭 플랫폼으로 옮길 때 발생하는 기술적 마찰도 관리한다. 클립이 성공적으로 내보내기 되었으나 채팅 인터페이스에서 게시 준비 완료 상태로 연결되지 않는 경우, 클로드는 연결 오류를 스스로 복구할 수 있다. 다른 내보내기 후 게시 순서를 작동시켜 파일을 밀어 넣는 방식으로 문제를 해결한다. 일정을 최종 확정하기 전에 AI는 내보내기 상태를 확인하고 연결된 계정 세부 정보를 검증한다.
02클로드 오퍼스 5의 시스템 해킹 — 복잡한 공격 자동 실행
인공지능(AI)이 단순한 버그 찾기를 넘어 소프트웨어 시스템을 직접 뚫는 공격 수행 단계로 진화하고 있다. 최근 테스트에 따르면 클로드 오퍼스(클로드 Opus) 시리즈는 기존에 AI의 능력을 넘어서던 고도의 공격형 보안 작업을 수행할 수 있는 것으로 나타났다. 이 변화는 AI가 서버 인프라를 완전히 장악하는 데 악용될 수 있으며, 공격자가 원하는 모든 명령을 실행할 수 있음을 뜻한다.
이러한 진화는 업계가 놓친 보안 취약점을 정교하게 찾아내는 능력을 보여준 오퍼스 4.8(Opus 4.8) 버전부터 시작됐다. 특히 이 모델은 공인된 소프트웨어 보안 취약점 데이터베이스인 CVE(Common Vulnerabilities and Exposures) 목록에 등록되지 않은 허점을 찾아냈다. 여기에는 시스템이 특정 파일을 이미지 처리 도구로 넘기는 과정에서 발생하는 이미지 처리 작업 흐름(workflow) 문제의 발견도 포함됐다. 지난 7월 5일, 오퍼스 4.8은 힙 버퍼 오버플로(heap buffer overflow)를 활용해 코드를 실행하는 공격을 성공적으로 만들어냈다. 이 공격 방식은 시스템이 처리할 수 있는 용량을 넘어서는 데이터를 메모리에 쏟아부어 시스템 메모리를 덮어쓰고, 이를 통해 인가되지 않은 코드를 강제로 실행하도록 만든다.
오퍼스 5(Opus 5)의 출시는 공격력 측면에서 상당한 도약을 이뤄냈다. 오퍼스 4.8이 디스코스(Discourse) 커뮤니티 포럼 소프트웨어에서 취약점을 찾아내고도 실제 시스템을 뚫는 능력은 부족했던 반면, 오퍼스 5는 동일한 결함을 성공적으로 악용할 수 있었다. 실행 속도 또한 주목할 만했다. 7월 25일 오전 6시쯤 필요한 구성 요소들이 작동하기 시작했고, 같은 날 오전 10시에는 오픈AI가 호스팅한 인스턴스에서 원격 코드 실행(remote code execution)을 달성했다. 원격 코드 실행은 사용자가 인프라를 완전히 장악해 원하는 소프트웨어나 명령을 무엇이든 실행할 수 있게 만들기 때문에 사이버 공격에서 가장 치명적인 단계에 해당한다.
03앤스로픽은 왜 모델 개별 출시 대신 전체 라인업 동시 공개로 돌아설까?
클로드 사용자들은 앞으로 개별 버전이 천천히 순차적으로 나오는 방식 대신 여러 모델 등급에 걸친 동시 업데이트를 보게 될 전망이다. 앤스로픽은 단일 업데이트 배포 방식에서 벗어나 전체 모델 라인업을 한꺼번에 출시하는 전략으로 선회하는 모양새다. 일반 사용자와 개발자 입장에서는 이 변화가 더 예측 가능한 업그레이드 경로를 의미한다. 고성능의 복잡한 모델과 더 빠르고 효율적인 버전 사이에 몇 달씩 기다리는 대신, 업데이트된 도구 모음을 한 번에 이용해 버전 불일치 없이 다양한 성능 수준을 오갈 수 있다.
이 같은 전략 변화 가능성은 최근 테스트 패턴에서 뒷받침된다. 오푸스 5.2(Opus 5.2)와 페이블 5.2(Fable 5.2)가 비교적 곧 출시될 것으로 예상되며, 테스트 과정에서 새로운 소넷(Sonnet) 모델의 흔적도 포착된 정황이 있다. 하이쿠(Haiku) 모델은 약 반년 동안 조용한 상태를 유지했지만, 이들 다른 버전이 동시에 준비되는 모습은 조율된 움직임을 시사한다. 테스트 단계에서 여러 모델이 동시에 포착된다는 점은 클로드 생태계를 새롭게 단장할 상당한 무언가가 물밑에서 개발되고 있음을 보여준다.
전체 라인업을 동시에 출시하면 한 번의 움직임으로 전체 제품 생태계를 재정의할 수 있다. 앤스로픽은 여러 등급을 한꺼번에 선보임으로써 가장 복잡한 작업을 위한 최고 수준의 추론 능력부터 단순한 질의를 위한 더 빠르고 비용 효율적인 성능까지, 다양한 요구에 맞춘 명확하고 동기화된 선택지를 제공할 수 있다. 페이블 5.2, 오푸스 5.2, 그리고 소넷 변형 모델의 동시 개발은 앤스로픽이 AI 제품군의 전면적인 개편을 우선시하고 있음을 시사한다. 이 접근법은 회사를 과거에 여러 모델을 동시에 선보이던 방식으로 되돌려, 전체 모델 가족군이 동일한 속도로 진화하도록 보장하는 효과를 낸다.
04코어위브, 서버리스 추론 속도와 안정성 개선
개발자가 AI 성능을 테스트할 때 측정 도구의 결함을 서버 병목 현상으로 오인하는 경우가 있다. 일부 성능 측정용 검증 장치(benchmark harness)는 실시간 토큰 요청을 수집하는 데 어려움을 겪으며, 이로 인해 최대 58초의 인위적인 지연이 발생할 수 있다. 이를 해결하기 위해 CNCF 프로젝트인 inferenceperf는 파이썬(Python)의 전역 인터프리터 잠금(Global Interpreter Lock)을 우회하는 다중 프로세스 부하 생성기를 활용한다. 이 잠금은 언어가 동시에 수행할 수 있는 작업 수를 제한하는 메커니즘이다. 이를 통해 성능 지표가 추론 테스트 소프트웨어 자체의 부하가 아니라 서버의 실제 속도를 정확하게 반영하도록 보장한다.
코어위브(CoreWeave)는 엄격한 서비스 수준을 유지하기 위해 서버리스 추론 플랫폼 내에서 이와 유사한 신뢰성 조치를 구현하고 있다. 트래픽 예측이 가능한 고객을 위해 이 회사는 프로비저닝된 처리량을 제공하며, 이를 통해 전용 용량을 확보하여 다른 사용자의 작업 부하 때문에 특정 고객의 성능이 느려지는 '노이지 네이버(noisy neighbor)' 문제를 방지한다. 입력 시퀀스의 80%에서 90%를 자주 반복하는 작업 흐름을 더욱 최적화하기 위해 코어위브는 캐시 인식 라우팅을 사용한다. 프롬프트를 처리하는 데 필요한 초기 계산 비용을 반복하는 대신, 시스템은 키-값 캐시 즉 모델의 대화 단기 기억을 대역폭이 높은 저장소로 오프로드한다. 이를 통해 데이터를 메모리에 빠르게 다시 불러올 수 있으며, 비용과 지연 시간을 모두 줄인다.
05공개 가중치 모델 vs 폐쇄형 최고 성능 모델 — 비용 효율성과 압도적 성능의 갈림길
공개 가중치 모델(open weight models)은 내부 매개변수가 공개된 AI 시스템으로, 폐쇄형 독점 시스템 비용의 극히 일부만으로 복잡한 자동화 업무 흐름(workflow)을 처리할 수 있는 품질 수준에 도달했다. 타워 디펜스 게임을 만드는 실전 테스트에서 FriendliAI 추론 클라우드에서 실행된 GLM 5.2는 앤스로픽의 Opus 4.8보다 비용이 약 5.6배 저렴하면서도 완전한 기능을 유지했다. 이러한 변화는 개발자가 목표를 달성하기 위해 연속적인 고리로 계획하고 행동하며 관찰해야 하는 AI 에이전트를 배포할 때 겪는 재정적 장벽을 크게 낮춘다.
이러한 에이전트를 실제 운영 환경에서 쓸 수 있게 만들기 위해 업계는 단일 응답 속도에서 전체 작업 완료에 필요한 총 시간으로 초점을 옮기고 있다. 에이전트는 계획과 행동의 주기를 반복하기 때문에 초기 문맥의 커다란 블록을 반복해서 재사용하는 경우가 많다. FriendliAI는 키-값 캐시(key-value cache)로 알려진 이 공유 문맥의 처리된 상태를 저장하는 기술인 프리픽스 캐싱(prefix caching)을 통해 이를 최적화하므로 모델은 이어지는 단계에서 새로운 정보만 처리하면 된다. 이는 연산 낭비를 줄이고 모델이 응답을 시작하는 데 걸리는 시간을 단축한다. KiloCode가 진행한 테스트에서 FriendliAI는 이러한 연속 작업을 고립된 요청이 아니라 하나의 프로그램으로 다룸으로써 GLM5의 성능을 다른 타사 제공업체와 모델 연구소 G.A.I.보다 7배 빠른 속도로 입증했다.
최적화된 공개 가중치 모델이 우수한 경제성을 제공하는 한편, 폐쇄형 최고 성능 모델(proprietary frontier models)은 여전히 순수 능력의 한계치를 끌어올리고 있다. 앤스로픽은 클로드 코드 내의 비밀 라우팅을 통해 Fable 5.2와 Opus 5.2를 은밀히 테스트하고 있는 것으로 전해진다. Fable 5.2는 단 한 번의 생성을 통해 실제와 같은 수준의 프로덕션급 3D 애니메이션과 게임 같은 결과물을 만들어내며 현실감에서 큰 도약을 보여주었다. 일부 초기 육안 테스트에서는 이러한 결과물이 GPT6 Astra가 만들어낸 결과물보다 더 뛰어난 것으로 나타났다. 하지만 많은 개발자에게 이러한 선택의 기로는 이 폐쇄형 모델의 최고 수준 지능과 전체 작업 완료에 최적화된 공개 가중치 모델의 속도 및 비용 효율성 사이의 선택이 되어가고 있다.
06클로드 코드 2.1.277 버전: 새 설정 파일 지원과 맞춤형 확장 기능 도입
클로드 코드는 프로젝트 규칙을 인식하는 방식을 단순화해 개발자 편의성을 높인다. 이번에 나온 버전 2.1.277에서는 agents.md라는 보조 설정 파일을 새로 지원한다. 기존에는 폴더의 맥락과 규칙을 이해하기 위해 특정한 클로드 MD 파일 하나만 바라봐야 했다. 이제는 이 주력 파일이 없더라도 클로드 코드가 자동으로 agents.md 파일을 찾아 활용한다. 이 변화 덕분에 다양한 개발 환경에서 도구를 설정할 때 겪는 번거로움이 줄어들며, 안내 문서의 이름이 달라도 문제없이 인식한다. 개발자 입장에서는 소프트웨어의 요구사항에 맞추느라 파일 이름을 바꾸느라 낭비하는 시간이 줄어들고, 서로 다른 프로젝트 구조를 오갈 때 작업이 훨씬 매끄러워진다. 설정을 엄격하게 통제하고 싶은 사용자는 /config 명령어를 이용해 이 자동 검색 기능을 직접 켜거나 끌 수도 있다.
이 당장의 업데이트를 넘어, 클로드 코드는 더 깊이 있는 전문가 맞춤 설정을 지원하는 개방형 구조로 나아가는 중이다. 도구의 작동 방식을 관리하는 기본 틀인 클로드 코드 검증 장치(클로드 코드 harness)를 개발자가 직접 수정하고, AI가 작업을 수행할 때 따르는 규칙인 제품 지침의 독자적인 버전을 만들 수 있는 새 시스템이 개발되고 있다. 클로드 코드 개조(클로드 코드 mods) 기능을 활용하면 개발자는 도구의 핵심 동작을 회사의 코딩 표준이나 고유한 프로젝트 요구사항에 딱 맞게 조정할 수 있다. 이 변화는 소프트웨어를 획일적인 유틸리티에서 맞춤형 플랫폼으로 탈바꿈시킨다. 모든 팀에 똑같이 적용되는 방식을 따르는 대신, 앞으로는 팀마다 AI가 코드베이스와 상호작용하는 방식을 정확하게 정의할 수 있으며, 이를 통해 사내 정책이나 특정 기술적 업무 흐름을 철저히 따르게 만든다.
07슈퍼링크드(Superlinked)의 자동화 연구 고리를 통한 모델 튜닝 효율화
기업은 모델 조율 과정을 자동화하여 새로운 인공지능(AI) 모델을 연동하는 데 드는 시간과 비용을 크게 줄일 수 있다. 최적의 성능을 찾기 위해 설정을 일일이 수동으로 조정하는 대신 시스템이 이러한 조정을 자동으로 처리하므로, 조직은 비용이 많이 드는 관리형 서비스에서 벗어나 자체 인프라로 전환할 수 있다. 이러한 변화는 상당한 비용 절감과 최종 사용자의 훨씬 빠른 응답 시간으로 이어지며, 복잡한 기술적 난제를 간소화된 운영상의 이점으로 바꾼다.
슈퍼링크드(Superlinked)는 자동화 연구 고리(automated research loops)를 활용하여 이러한 효율성을 구현한다. 이는 내부 측정 도구와 상위 제어 프로세스인 메타 고리(meta-loop)를 사용하여 테스트 프레임워크 또는 검증 장치(harness)를 구축하는 특화된 시스템이다. 전체 컴퓨팅 클러스터에 대한 포괄적인 구성을 하나로 묶음으로써, 팀은 번거로운 수동 매개변수 탐색 과정을 피한다. 전통적인 AI 개발에서 매개변수 탐색은 속도와 정확도의 최적 균형을 찾기 위해 수십 가지의 서로 다른 설정을 일일이 수동으로 테스트하는 과정을 뜻하며, 이는 시간이 오래 걸리고 인적 오류가 발생하기 쉽다.
이 접근 방식의 실질적인 이점은 자체 호스팅 오픈소스 모델을 관리형 임베딩 엔드포인트와 비교할 때 가장 명확하게 드러난다. 관리형 엔드포인트는 제공업체가 모델을 호스팅하고 사용자가 요청마다 비용을 지불하는 서비스다. 오픈AI나 코히어(Cohere) 같은 제공업체의 관리형 서비스는 흔히 수백 밀리초의 지연 시간(latencies)을 발생시킨다. 대조적으로, 간소화된 내부 설정을 이용하면 이러한 응답 시간을 낮은 수십 밀리초 수준까지 낮출 수 있다. 소수의 그래픽처리장치(GPU)와 집중된 인프라를 활용함으로써, 기업들은 비교적 쉬운 업무 흐름을 유지하면서도 대규모 비용 절감을 달성하며 이러한 성능 향상 효과를 손쉽게 얻을 수 있다.
08루벤 시스템즈의 NVFP4 가속 — 인프라 효율과 성능의 도약
인공지능(AI)이 답변을 만들어내는 과정인 추론(Inference) 속도가 새로운 하드웨어와 데이터 형식을 만나 한 단계 더 빨라질 전망이다. 새롭게 등장할 루벤 시스템즈(Reuben systems)는 NVFP4 데이터 형식을 활용해 대폭 향상된 성능을 보여줄 것으로 기대를 모으고 있다. 이 형식은 복잡한 숫자를 압축하는 양자화(Quantization) 방식을 통해 적은 메모리로도 데이터를 더 빠르게 처리하도록 돕는다. 필립 키엘리(Philip Kiely)는 대규모 데이터센터에서 이 잠재력을 온전히 끌어내려면, 개발자들이 기기 내 로컬 추론에서 쓰이던 기술을 응용해 NVFP4 환경에서 대형 모델을 구동할 신뢰를 쌓아야 한다고 제안한다.
코어위브(CoreWeave) 같은 인프라 기업들은 이미 고객에게 더 나은 가격 대비 성능을 제공하기 위해 NVFP4 양자화를 핵심 수단으로 삼고 있다. 이들은 양자화 외에도 사전 입력 단계와 답변 생성 단계를 분리하는 사전 입력-디코딩 분리(Prefill-decode disaggregation) 전략을 도입하고 있다. 사전 입력 단계는 모델이 입력된 명령어를 읽고 이해하는 과정이며, 디코딩 단계는 토큰 단위로 답변을 순차적으로 생성하는 과정이다. 이 두 단계를 서로 떼어놓고 여러 프로세서에 작업을 나누는 병렬화 수준을 세밀하게 조절하면, 복잡한 질문을 처리하는 모델의 효율성을 크게 높일 수 있다.
이러한 효율성의 핵심에는 대화의 수학적 상태를 임시로 저장하는 키-값 캐시(Key-value cache) 관리 방식이 자리 잡고 있다. 사용자가 새로운 메시지를 보낼 때마다 기존 데이터를 완전히 지우고 전체 명령어를 다시 처리하는 대신, 코어위브는 캐시를 대역폭이 높은 저장소로 오프로드한다. 덕분에 후속 요청이 들어올 때 대화 기록을 고성능 메모리로 곧바로 불러올 수 있다. 이 방식은 불필요한 연산을 줄여주며, 전체 채팅 기록을 다시 분석하느라 발생하는 지연 없이 매끄럽고 즉각적인 상호작용을 지원한다.
09아마존웹서비스(AWS) 베드록을 쓰면 기업이 AI 자산을 소유할 수 없는 이유는 무엇일까?
아마존웹서비스(AWS) 베드록(Bedrock)을 통해 오픈소스 인공지능(AI)을 활용하는 기업들은 눈앞의 편리함을 얻는 대신 장기적인 경쟁력을 잃을 위험이 있다. 가장 큰 문제는 최신성 부족이다. 베드록에 등록된 모델 목록은 제한적인 경우가 많으며, 현재 업계 최고 수준인 최첨단 기술보다 2년에서 3년 뒤처질 수 있다. 이는 기업이 전체 오픈소스 진영에서 제공되는 기술보다 훨씬 뒤떨어진 구형 기술을 현장에 도입하고 있을 수 있음을 뜻한다.
이러한 한계는 기업이 인공지능을 맞춤 설정하는 과정에서도 그대로 나타난다. 기업이 특정 데이터셋으로 모델을 추가 학습시켜 특정 업무에서의 성능을 높이는 미세조정(fine-tuning)을 거치더라도, 그 결과물인 학습 결과물을 실제로 소유하지는 못한다. 이 결과물은 모델을 특화시키는 디지털 가중치나 학습된 패턴을 말한다. 베드록 환경에서는 이러한 자산이 사용자에게 전달되지 않고 클라우드 제공업체의 인프라에 그대로 남는다.
이러한 미세조정 결과물은 외부로 추출할 수 없기 때문에 어디서나 활용할 수 있는 독자적인 사업 무기로 쓰기 어렵다. 기업이 특화된 지능을 다른 플랫폼으로 옮기거나 학습된 모델을 고유한 지식재산으로 다루지 못한다는 뜻이다. 이는 vLLM이나 SGLang 같은 오픈소스 인프라 솔루션과 극명한 대조를 이룬다. 이러한 도구들은 복잡한 매개변수 탐색과 하드웨어 최적화 등 직접 구축하는 방식을 거쳐야 하지만, 사용자가 완벽한 통제권을 유지할 수 있게 돕는다. 결국 기업들은 아마존웹서비스(AWS) 베드록이라는 관리형 서비스를 선택함으로써 인공지능 연구개발의 결과물을 직접 소유할 권리를 포기하게 된다.
10수퍼링크드가 최적화 과정을 자동화해 훈련 비용 80센트와 성능 향상 18%를 이끌어낸 방식
인공지능 모델을 설정하는 과정은 보통 수많은 매개변수 조합을 일일이 테스트해야 하는 번거롭고 시간이 오래 걸리는 작업이다. 개발자들은 최적의 성능을 내는 설정을 찾기 위해 수십 가지 조합을 손수 시험해 봐야 한다. 이 과정은 프로젝트를 시제품 단계에서 실제 서비스용 도구로 넘기는 데 큰 걸림돌이 된다. 수퍼링크드(Superlinked)는 여러 모델이 함께 작동하는 모델 군집에 미리 설정된 통합 구성을 제공해 이 병목 현상을 없앤다. 사용자가 직접 알맞은 숫자를 찾아 헤매는 대신, 최적화가 이미 완료된 모델 지원 기능을 제공하므로 개발자는 수동 설정을 건너뛰고 곧바로 구현 단계로 넘어갈 수 있다.
이러한 간소화된 경험은 최적화의 무거운 작업을 처리하도록 설계된 자동화 연구 순환 과정을 통해 가능해졌다. 이 시스템은 최적화 과정을 실행하는 데 필요한 테스트 틀(harness)인 검증 장치를 자동으로 구축하는 메타 루프를 활용한다. 처리 과정이 블랙박스가 되지 않도록 수퍼링크드는 개발자가 시스템 동작 방식과 설정 도출 과정을 정확히 파악할 수 있는 사용자 인터페이스와 대시보드를 제공한다. 플랫폼은 최적의 설정을 자동으로 찾아내며 수동 엔지니어링 작업을 예측 가능한 소프트웨어 중심의 결과물로 바꾼다.
이 접근 방식의 실질적인 효과는 최소한의 자원으로 고성능 특화 모델 업데이트를 만들어내는 능력에서 나타난다. 개념 증명 단계에서 이 시스템은 전체 시스템을 다시 학습시킬 필요 없이 모델을 가볍게 미세 조정하는 방식인 로라(LoRA)를 만드는 데 활용됐다. 이 구체적인 업데이트는 훈련 비용이 80센트에 불과했지만 독일어 법률 문서의 정보 검색 품질을 18% 끌어올렸다. 이 결과는 막대한 연산 예산이나 수주간의 수동 매개변수 조정 없이도 작고 효율적으로 조율된 모델이 큰 품질 향상을 이끌어낼 수 있다는 인공지능 개발의 거대한 변화를 보여준다.
11오픈AI 내부망 해킹당해 — 핵심 코드와 직원 계정 유출
오픈AI가 핵심 자산이 대거 유출되는 심각한 보안 사고를 겪었다. 72시간도 안 되는 짧은 시간 동안 해커들이 회사의 방어벽을 뚫고 직원 개인 계정과 핵심 코드 보관소를 무단으로 장악했다.
이번 해킹으로 직원인 ChatGPT와 Codex의 계정이 뚫렸다. 더 큰 문제는 해커들이 오픈AI의 내부 단일 저장소(mono repo)까지 침투했다는 점이다. 단일 저장소(mono repo)는 회사의 모든 데이터와 코드를 여러 곳으로 나누지 않고 한곳에 모아 관리하는 중앙 집중식 시스템이다. 이 구조 때문에 해커들은 서비스 백엔드 코드와 모델 학습용 인프라, 필수 연구 도구, 유해 콘텐츠 생성을 막는 안전 시스템까지 독점 정보가 담긴 핵심 자산 전체에 접근할 수 있게 됐다.
이번 공격 방식은 아이러니하게도 경쟁사인 앤스로픽의 AI 모델인 클로드를 활용해 오픈AI를 뚫은 것으로 알려졌다. 이는 AI가 단순히 공격 대상에 머무르지 않고 다른 AI 기업의 보안을 무너뜨리는 무기로 쓰이는 보안 환경의 변화를 보여준다. 이번 사건은 오랜 기간 연재된 만화 속에서 현대 디지털 인프라를 위협하는 보안 실패와 해킹 시도가 반복해서 예견되어 온 흐름과도 맞닿아 있다. 정교한 AI 모델을 이용해 다른 AI를 뚫은 이번 공격은 AI 기업들이 내부 지적재산권을 보호하는 방식에 심각한 허점이 있음을 드러냈다.
12AI가 찾아낸 보안 허점: 사람이 놓친 구조적 결함의 실체
많은 기업은 그동안 철저하다고 믿었던 소프트웨어 시스템에 실제로는 구멍이 뚫려 있다는 사실을 마주하고 있다. 이러한 깨달음은 AI 도구가 그간 사람이 놓쳐온 구조적 취약점을 찾아내는 뛰어난 능력을 증명하면서 나타나고 있다. 인간 전문가가 가장 눈에 띄는 진입점을 점검하거나 표준 보안 점검표를 따를 때, AI는 시스템 전체를 샅샅이 훑을 수 있다. 이를 통해 AI는 아키텍처를 설계하고 구축한 사람들이 이전에는 보지 못했던 복잡한 실패 패턴과 숨겨진 결함을 찾아낸다.
이러한 변화를 시각적으로 이해하려면 집을 짓고 벽과 천장을 검사하는 상황을 떠올리면 된다. 사람의 눈에는 뚜렷한 균열이 없어 구조가 완벽하게 밀폐되고 안전해 보인다. 하지만 AI가 그 집을 분석하면 건축업자가 단순하게 놓친 수많은 숨겨진 구멍을 정확히 집어낼 수 있다. 이러한 능력은 보안을 고정된 가정의 영역에서 역동적인 발견의 과정으로 바꾸어 놓으며, 많은 디지털 환경이 지닌 체감 안전성이 한정된 인간의 시각에 기반한 착시였음을 드러낸다.
이러한 간과가 초래할 실제 위험은 대규모 데이터 유출 가능성에서 보듯 매우 크다. 최근 한 사례에서는 공격자가 시스템에 침입해 민감한 정보를 훔칠 수 있는 기간을 열어둔 취약점이 2달 동안 방치되어 있었다는 사실이 밝혀졌다. 이 특정 결함은 사용자가 구글 계정을 통해 서비스에 로그인하는 방식, 즉 전통적인 비밀번호가 필요 없는 방식과 연관되어 있었다. 이 발견은 오픈AI가 해당 허점을 찾아낸 측에 6,500달러의 포상금을 지급했을 정도로 중요했다. 이 사례는 데이터를 보호하는 방식이 그 보호망을 해체할 수 있는 AI 도구보다 뒤처지고 있다는 더 넓은 구조적 추세를 보여준다. 기업의 입장에서는 전통적인 사람의 검토에만 의존하는 것이 사용자 정보의 안전을 보장하기에 더 이상 충분한 전략이 아님을 의미한다.