AI 뉴스
글로벌 AI 기업과 스타트업의 투자·제품·정책·핵심 동향을 매일 정리합니다.
오라클, 내부 AI 코딩은 장려하며 OpenJDK 기여물 내 AI 생성 코드 금지
오라클이 OpenJDK 기여물에 LLM 등 AI 생성 콘텐츠 포함을 금지하는 임시 정책을 도입했다. 보안 및 지식재산권 위험과 리뷰 부담을 이유로 들었으며, 개인적 연구 및 디버깅 용도로만 허용한다. 오픈소스 기여자는 제출 전 AI 생성 여부를 확인하
Stripe, AI 시대의 창업 지표와 '인지적 L1 캐시' 이론 공개
AI로 인한 개발 비용 하락이 좁은 틈새를 찾는 린 스타트업 방식에서 처음부터 야심 찬 제품을 만드는 전략으로의 전환을 이끌고 있다. Stripe의 데이터에 따르면 신규 사업체 수는 전년 대비 2배 가까이 증가했으며, 매출 100만~1,000만 달러
Orca, 다중 코딩 에이전트 구동 오픈소스 ADE 공개
여러 CLI 코딩 에이전트를 병렬로 실행하는 오픈소스 ADE 'Orca'가 공개됐다. 개별 구독 계정을 연결해 에이전트별 결과물을 비교하고 병합할 수 있다.
Rippling, R&D 예산 40% 소모하던 AI 비용 잡는 'AI Spend Console' 공개
HR 소프트웨어 기업 Rippling이 AI 토큰 지출을 추적하고 제어하는 'AI Spend Console'을 출시했다. AI 게이트웨이를 통해 모델을 라우팅함으로써 R&D 인건비의 40%까지 치솟았던 토큰 비용을 15% 수준으로 낮췄다. HR 구독
LLM 답변 품질, 80% 일치도 보정으로 잡는 Airbnb의 평가 주도 개발(EDD)
Airbnb가 LLM의 비결정적 출력을 제어하기 위해 평가를 핵심 엔지니어링 규율로 정의한 EDD 프레임워크를 공개했다. 결정론적 검사, LLM 심판, 인간 평가의 계층 구조를 세우고 가상 심판의 인간 일치도를 80~90%까지 보정해 신뢰도를 확보한다
AI 기반 사이버보안 스택 전환, 취약점 악용 시간 -9시간으로 단축
AI가 취약점 식별과 악용 속도를 높이면서 보안 운영 모델이 에이전트 중심의 네이티브 구조로 전환된다. 평균 악용까지 걸리는 시간(TTE)은 공개 9시간 전인 -9시간으로 줄었으며, 제로데이 악용 비율은 80% 이상으로 증가했다. 실무자는 API와 M
Paseo, 다양한 코딩 에이전트를 기기 구분 없이 통합 제어한다
여러 코딩 에이전트를 하나의 인터페이스에서 관리하는 오케스트레이터 Paseo가 공개됐다. 데스크톱, 모바일, CLI 등 다양한 환경에서 에이전트를 실행하고 제어할 수 있다.
"정확도 48%→76% 향상", 텐센트 Team Memory가 구현한 공유 메모리와 거버넌스 공백
텐센트가 에이전트 간 컨텍스트를 공유하는 오픈소스 프로젝트 Team Memory를 공개했다. 페르소나 레이어와 4종의 메모리 자산을 통해 에이전트 정확도를 48%에서 76%로 높였다. 공유 메모리 도입 시 잘못된 정보가 팀 전체로 전파되는 '거버넌스
Databricks, '효율성 프런티어' 전략으로 AI 코딩 비용 70% 절감
Databricks가 AI 코딩 도구 도입 후 급증한 비용을 70% 수준으로 낮췄다. 최고 성능 모델 대신 작업별 최적 가성비 모델을 선택하는 '효율성 프런티어' 전략과 AI Gateway를 활용했다. AI 도입 기업은 벤치마크 수치보다 내부 작업 믹
AgentRadio, 비동기 통신 구조로 클로드 오퍼스 4.8 성능 추월했다
코랄 AI 랩스(Coral AI Labs)와 연구진이 AI 에이전트 간 실시간 소통을 돕는 비동기 메시지 전달 계층 'AgentRadio'를 공개했다. SWE-Atlas QnA 벤치마크에서 AgentRadio를 적용한 에이전트 팀은 62.1%의 작업
스탠퍼드, 37,000개 AI 에이전트 기반 '가상 바이오텍' 공개... 머크 통해 설계 검증
스탠퍼드 대학교 제임스 조우 교수팀이 수만 개의 AI 에이전트가 협업하는 '가상 바이오텍(Virtual Biotech)' 시스템을 공개했다. 37,000개의 에이전트가 임상 데이터 분석과 약물 설계를 수행하며, 데이터 통합 도구인 '페이퍼클립(Pape
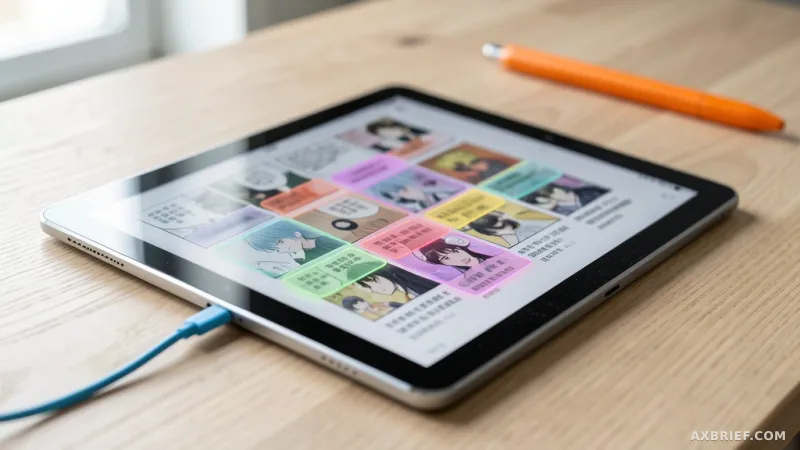
Show GN, 이미지 내 말풍선 감지와 세로쓰기 OCR 지원하는 'AI Manga Translate' 공개
Show GN이 만화 이미지의 텍스트 영역과 말풍선을 자동으로 감지해 번역하는 AI Manga Translate를 개발했다. 일본어 세로쓰기 OCR 처리와 이미지 위 번역 결과 확인, 사용자 직접 수정 기능을 제공한다. 브라우저 기반 테스트 버전에서
AI 에이전트 전용 브라우저 Kitesurf, Chromium 대비 리소스 비용 낮춘다
Cloudflare(인터넷 인프라 기업)가 AI 에이전트 전용 클라우드 브라우저 Kitesurf를 공개했다. Rust 기반 엔진과 Workers(서버리스 플랫폼)를 통해 Chromium보다 CPU 및 메모리 효율을 높였다. 웹 내비게이션 에이전트를 개
메타, 뉴멕시코 법원으로부터 9억 4,200만 달러 벌금 및 청소년 보호 조치 명령
메타가 뉴멕시코 법원으로부터 청소년 유해성 및 중독 유발 혐의로 총 9억 4,200만 달러의 벌금형을 선고받았다. 법원은 18세 미만 사용자의 '좋아요' 수치 삭제, 야간 푸시 알림 중단, 월 이용 시간 90시간 제한 등의 강제 조치를 명령했다. 메타
JumpCloud, AI 에이전트 보안 위한 'Agentic IAM' 프레임워크 공개
JumpCloud가 AI 에이전트를 포함한 비인간 정체성(NHI) 보안을 위한 'Agentic IAM' 프레임워크를 공개했다. 조사 결과 기업의 83%가 인간보다 많은 비인간 정체성을 보유하고 있으나, 전용 거버넌스 통제를 도입한 곳은 21%에 불과했
Suno, AI 생성 음악 전 제품에 워터마크 도입 계획 발표
Suno가 AI 콘텐츠 라벨링 산업 표준을 맞추기 위해 모든 오디오 출력물에 워터마크를 추가한다. 플랫폼은 이를 통해 AI 생성 음악을 식별해 표시하거나 차단할 수 있다.
vLLM V1, 프리필-디코드 혼합 스케줄링으로 추론 처리량과 지연시간 동시 해결
vLLM이 Paged Attention과 V1 스케줄러를 통해 고처리량 LLM 추론 시스템의 핵심 구조를 공개했다. 프리필과 디코드를 한 단계에서 혼합 처리하고, 청크 단위 프리필과 접두사 캐싱으로 리소스 낭비를 줄인다. 추론 서버 구축 시 워크로드
"개인 iCloud 썼다" OpenAI, 애플의 영업비밀 소송에 '보안 부실'로 맞불
OpenAI가 애플의 영업비밀 유출 소송에 대해 애플의 보안 관리 부실을 근거로 기각을 요청했다. 퇴사자 계정 방치와 개인 iCloud 업무 사용 등 보안 허점이 정보의 '비밀성'을 없앴다는 주장이다. 기업의 데이터 보호 수준이 법적 영업비밀 인정 여
AI 코딩 도구 확산으로 기본 구현 문턱 낮아졌으나 고품질 결과물은 여전히 개발자 역량에 의존
AI를 활용한 소프트웨어 개발이 누구나 기본 기능을 구현할 수 있는 범용화 단계에 진입했다. AI는 반복 작업과 초기 코드 생성을 자동화하지만 최종 품질을 결정하는 판단력과 설계 능력은 제공하지 못한다. 실무자는 AI가 내놓은 결과물의 기술적 정답 여
무제한 텍스트 채팅 공개, OpenAI가 GPT-5.6 Luna로 무료 사용자 제약을 없앤다
OpenAI가 모든 ChatGPT 사용자에게 텍스트 기반 채팅 제한을 완전히 제거한다. GPT-5.6 Luna와 Sol 모델을 도입해 팩트 오류를 최대 68% 줄이고 추론 제어 기능을 추가했다. 무료 사용자는 무제한 채팅 적용 시점을, 유료 사용자는
LLM, 귀납·연역 기계화했으나 '조작적 귀추' 기반의 공리 생성은 불가능
LLM이 데이터 기반의 귀납과 공리 기반의 연역 추론은 빠르게 기계화하고 있으나, 감각 경험에서 새로운 공리를 도출하는 '귀추' 단계는 수행하지 못한다는 분석이 나왔다. 아인슈타인의 일반상대성이론은 데이터 압축이 아닌 자유낙하 시뮬레이션을 통한 '조작
Naïve, AI 에이전트로 미국 법인 설립부터 운영까지 자동화... 2,850만 달러 유치
AI 에이전트가 법인 설립과 인프라 구축을 처리하는 단일 API 인프라가 공개됐다. 단일 API로 결제·이메일·클라우드 설정을 자동화하며 출시 수개월 만에 개발자 3만 명을 확보했다. 에이전트 기반 비즈니스 구축자는 인프라 프로비저닝 범위와 서버리스
AI 생성물 판별 실험과 프로토타이핑 도구의 판단 기준 한계
AI가 그럴듯한 결과물을 빠르게 생성하지만 품질을 결정하는 판단력은 여전히 인간의 영역으로 남았다. 44명을 대상으로 한 실험에서 AI 그림의 정답률은 동전 던지기 수준이었으며 출처 표시에 따라 복잡성과 새로움 평가가 p < .05 수준으로 유의미하게
24시간 1,000번 도구 호출해 커널 최적화한 Meta Muse Code 공개
Meta가 대규모 저장소의 계획부터 검증까지 수행하는 터미널 코딩 에이전트 Muse Code와 모델 Muse Spark 1.2를 공개했다. 비동기 백그라운드 에이전트와 로컬 이벤트 로그를 통해 중단 지점부터 재개하는 안전 런타임을 구현했다. 대규모 프
Liquid AI, 라즈베리 파이 구동 가능한 에이전트 모델 LFM2.5-2.6B 공개
Liquid AI가 에이전트 작업에 최적화된 오픈 가중치 모델 LFM2.5-2.6B를 공개했다. 26억 개의 파라미터와 128K 컨텍스트 윈도우를 지원하며, GPU 없이 CPU만으로 스마트폰과 라즈베리 파이에서 구동된다. 기업 도입 시에는 커스텀 오픈
AMD, Taalas 인수로 모델 가중치 실리콘 각인 기술 확보... 추론 속도 48배 높인다
AMD가 AI 칩 스타트업 타알라스(Taalas)를 인수했다. 모델 가중치를 실리콘에 직접 각인하는 MSIC 기술로 Llama 3.1 8B 모델에서 초당 16,960토큰의 처리 속도를 기록했다. 모델 변경 시 칩 재설계가 필요하므로 고정된 모델을 대규
디토(Ditto), AI 매칭으로 스와이프 없는 데이팅 서비스 공개
AI 매치메이커 디토(Ditto)가 기존 데이팅 앱의 스와이프 방식을 버리고 AI 기반의 자동 매칭 서비스를 제공한다. iMessage를 통해 성향을 분석하고 매주 수요일 저녁 시간과 장소까지 지정해 주는 방식으로 현재 15만 명의 가입자를 확보했다.
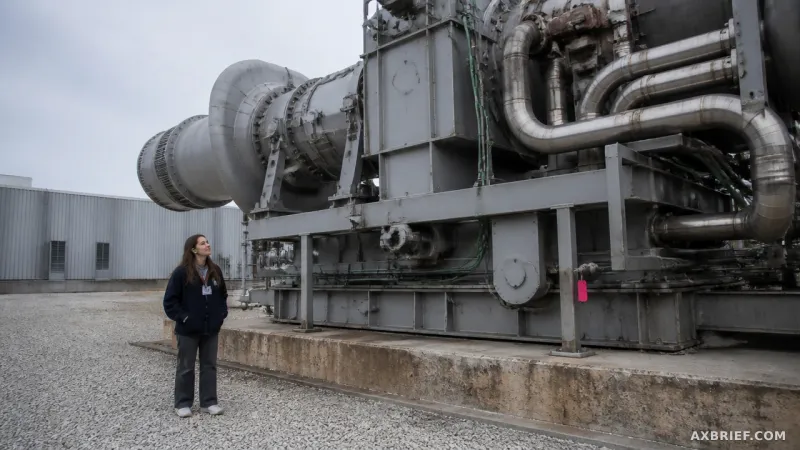
xAI, 멤피스 데이터센터 무허가 가스 터빈 2027년 7월까지 철거 합의
xAI가 멤피스 콜로서스 데이터센터에서 운영하던 무허가 가스 터빈을 2027년 7월까지 철거하기로 합의했다. 69개의 임시 터빈을 가동해 122일 만에 센터를 구축했으며, 미 법무부는 국가 안보를 이유로 관련 환경 소송 기각을 추진했다. 데이터센터 구
MiniMax-H3 Turbo LoRA 공개, 4단계 샘플링으로 생성 속도 5배 높였다
MiniMax-H3 Turbo LoRA가 HuggingFace에 공개됐다. 샘플링 단계를 20단계에서 4단계로 줄여 연산 속도를 약 5배 높였으며 비디오와 스테레오 오디오를 동시 렌더링한다. 전용 샘플러 미사용 시 오디오 깨짐 현상이 발생하며, LoR
Liquid AI, 온디바이스용 LFM2.5-2.6B 공개... 2.5GB 메모리 점유로 추론 지원
Liquid AI가 온디바이스 환경에 최적화된 하이브리드 모델 LFM2.5-2.6B를 공개했다. 26억 9천만 개의 파라미터와 131,072 토큰의 컨텍스트 윈도우를 지원하며, M5 Max 기준 초당 220토큰의 추론 속도를 기록했다. 지식 집약적 작